_alo_
Members
-
Joined
-
Last visited
-
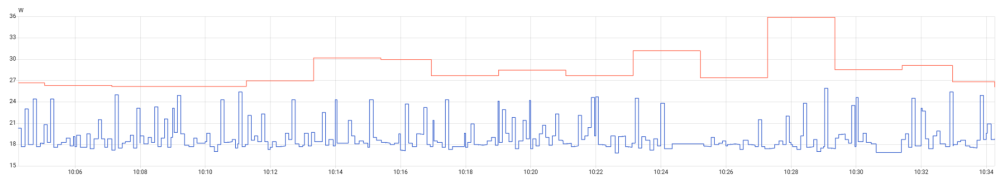
mein aktueller Verbrauch meiner Systeme aus der Signatur (rot=main, blau=backup): (das nackte System aus Board/CPU/Ram/USB-Stick/picoPSU brauchte jeweils minimal um die 10W) die 10G Netzwerkkarte meines großen Severs scheint übrigens leider gestorben zu sein :( da muss ich nochmal ran... Das ASUS N100I-D4 hab ich nicht wirklich viel stromsparender als das B760M bekommen und ist deswegen zugunsten der weiteren Möglichkeiten des größeren Systems rausgeflogen bzw. in mein 10" proxmox-Test-Cluster umgezogen. Bei mir hatte das Entfernen des an die HA-VM durchgereichten conbeeII USB-Sticks einiges gebracht. Ich bin auf einen (zentraler positionierten) SLZB06 mit PoE umgestiegen, weiß aber ehrlich gesagt gar nicht, was der verbraucht. Jetzt hab ich allerdings an beiden Servern eine USV per USB hängen 🤔
-
auch noch ein paar Punkte von mir: das war mir neu/unklar und hab das mal nachgelesen: für den reinen Betrieb braucht xfs quasi nichts, aber wenn xfs_repair notwendig wird, könnte es RAM-hungrig werden: demnach kämst du bei 14TB HDD so schnell in Richtung von eher 32GB als 16GB.... stimmt, aber diese Info ist auch fast 20 Jahre alt.... Wenn man hierzu genauer sucht: Diese Logik basiert primär auf der Anzahl an Inodes (Dateien auf der Platte) kommt noch aus einer Zeit, als Festplatten recht klein waren und bezog sich auf den Anwendungsfall im Datacenter von extrem vielen kleinen Dateien (Mailserver etc), also Millionen Dateien pro TB. Selbst dann war der RAM weniger das Problem, da dann auf den SWAP ausgewichen wurde. Heutzutage kommen -wie bei Dir mit Jellyfin- typischerweise vergleichsweise wenige große Dateien vor und dort reduziert sich der RAM-Bedarf schon wieder extrem ("bei 14TB Kapazität benötigt xfs_repair je nach Anzahl Dateien typischerweise zwischen 4 und 8GB RAM, selten mehr als 6GB"). Also ist der RAM bei xfs denke ich unkritisch und daher iirc auch hier im Forum bislang kein Thema gewesen... Bei wilden zfs-Konstrukten mag das anders sein. Naja, nur weil das Netzwerk 2,5GE kann, heißt das ja noch lange nicht, dass die auch durchgängig übertragen werden, da gehört ja noch einiges mehr zu. Das ist oft ein Denkfehler, das Netzwerk (oder den Maximalspeed einer HDD/NVMe) alleine zu betrachten. Da ist ja noch mehr beteiligt (und da steht für mich das Filesystem recht weit hinten in der Kette der beeinflussenden Faktoren): Quell-System (wie schnell kriegt das System die Daten überhaupt losgeschickt (HDD/SSD, CPU, Dateigröße/-anzahl, Betriebssystem/Anwendung,...)?) Anbindung Quell-System ans Netzwerk (LAN, WLAN) Netzwerk (beteiligte Geräte, Konfiguration, z.B. flow-control an/aus, ausreichende routing/switching Kapazität?) Anbindung Ziel-System ans Netzwerk (LAN, WLAN) Performance des Ziel-Systems (wie schnell kriegt das System die Daten von der Netzwerkkarte zum Speicher? CPU/RAM-Auslastung, PCIe Anbindung der Geräte, SMB/NFS, RAID-Controller...) Speicher Geschwindigkeit (z.B. SATA ca. 250MB/s, NVMe PCI3.0X4 ca. 4GB/s,... mit den zusätzlich einschränkenden Faktoren, die @DataCollector beschrieben hat) Dateisystem (sicherlich im Bereich des Messbaren) das kann also überall haken. Erst wenn alle Komponenten mitspielen bzw. richtig ausgelegt sind, erreichst Du auch die gewünschten Übertragungsraten. Vielleicht ist das ugreen NAS auch einfach so ausgelegt, dass es die >1GE nur über einen SSD-Cache ausreizen kann, wenn überhaupt...
-
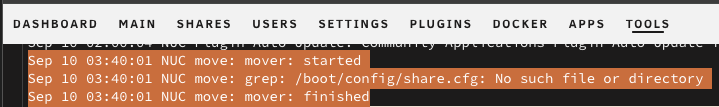
🤣ok Jetzt hab ich hierzu allerdings auch mal eine Frage an die Profis und möchte keinen extra Thread aufmachen - ich hoffe auf eine kurze Antwort wieso bekomme ich beim nächtlichen Mover-cronjob immer eine diese grep Fehlermeldung: Sep 30 03:40:01 NUC move: mover: started Sep 30 03:40:01 NUC move: grep: /boot/config/share.cfg: No such file or directory Sep 30 03:40:01 NUC move: mover: finishedbeim manuellen Aufruf aber nicht: Sep 30 18:48:19 NUC move: mover: started Sep 30 18:48:19 NUC move: mover: finishedP.S.: die /boot/config/share.cfg gibt es, mit diesem Inhalt: # Generated settings: shareDisk="auto" shareUser="e" shareUserInclude="" shareUserExclude="" shareUserEmptying="" shareUserExclusive="no" shareSMBEnabled="yes" shareNFSEnabled="no" shareNFSFsid="100" shareInitialOwner="Administrator" shareInitialGroup="Domain Users" shareCacheEnabled="yes" shareCacheFloor="2000000" shareMoverSchedule="40 3 * * *" shareMoverLogging="yes" shareNameVeto="/lost+found/LOST+FOUND/" fuse_remember="330" fuse_directio="auto" fuse_useino="yes" shareNOFILE="" shareAvahiEnabled="yes" shareAvahiSMBName="%h" shareAvahiSMBModel="Xserve"
-
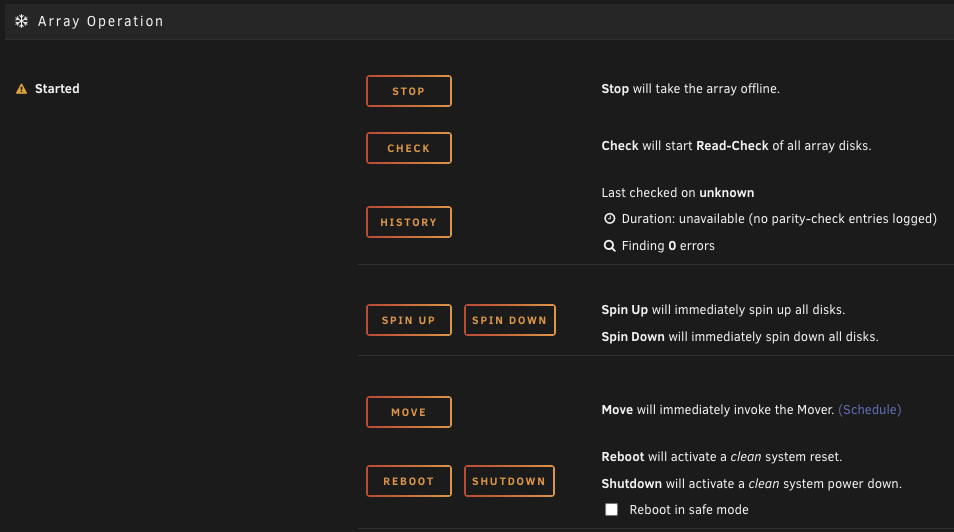
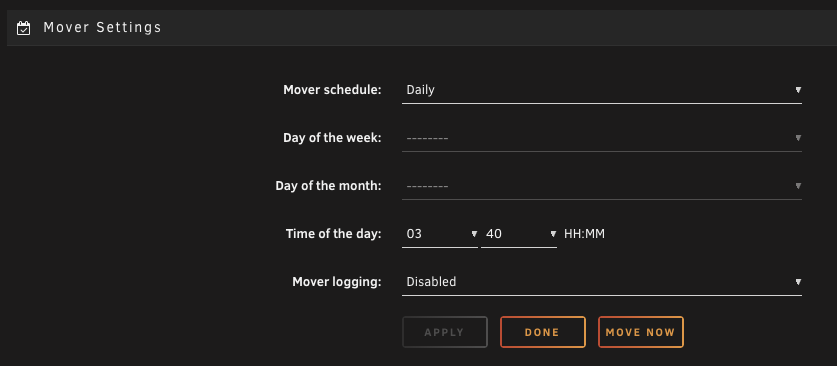
wann? wie du möchtest. Auf dem Main-Tab siehst Du unten bei den Array Operationen den Button "Move" - der ist zum manuellen Starten des Movers, so wie es dahinter auch beschrieben ist: hinter der Beschreibung ist dann der Link zum Scheduler, hier stellt man ein, wann der Mover laufen soll (täglich ist so default, es kann sein, dass ich die Uhrzeit angepasst habe): Auch hier kannst Du "Move now" anklicken, sollte das gleiche wie auf der Main Seite sein. Du siehst, dass er nach seiner Scheduler-Eintrag nachts startet und direkt fertig ist bei mir, da es keine zu movenden Daten gab: im Syslog unter Tools --> System Log Wenn Du in den Mover Settings noch das Logging aktivierst, wirst Du hier wahrscheinlich etwas mehr (jede Datei?) sehen. Ich hab gerade nichts zu moven, aber so siehts dann im Syslog aus, wenn ich "Move Now" klicke: mit der Uhrzeit von jetzt, sonst gleich ;) Ob er alles bewegt hat? Da geh mal von aus, wenn sie aktuell nicht im Zugriff sind (deswegen dürfen die Docker nicht laufen!), werden sie verschoben. Und sonst kannst Du -wie schon gesagt- ja auch nachsehen.
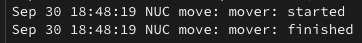
-
Genau, der "cd" Befehl bedeutet "change directory", d.h. du Wechselst in das angegebene Verzeichnis (alle Laufwerke sind ja in dem einem Verzeichnisbaum eingehängt/gemountet). Der nächste "copy"-Befehl "cp -ra [Quelle] [Ziel]" wird dann in diesem Verzeichnis ausgeführt. Er kopiert also das appdata Verzeichnis in ein neues Verzeichnis "appdata_sicherung", das Verzeichnis wird dabei automatisch erstellt. Die Option "-r" sorgt dabei dafür, dass rekursiv auch alle Unterverzeichnisse mitkommen und das "-a" dafür, dass alle Attribute übernommen werden (Eigentümer, Rechte, Zeitstempel,....). ja könntest du auch mit folgenden Anmerkungen: solche Operationen übers Webinterface machen, dauert nach meiner Erfahrung ewig, da wäre die Konsole schon tausendmal fertig. Aber es ist grundsätzlich möglich. da Ziel/Target muss dabei richtig gewählt werden!! Wenn du in /mnt/disk1/appdata gehst, dort alles markierst und als Ziel fürs Verschieben /mnt/cache (die SSD) auswählst, hast Du anschließend die Docker-Daten unter z.B. /mnt/cache/jellyfin und nicht /mnt/cache/appdata/jellyfin. Wenn man sowas manuell macht, muss man eben genau aufpassen, was man tut. Der Mover macht nichts anderes, als die Share-Ordner (hier: appdata) auf allen Laufwerken des arrays zu suchen und datei für datei rekursiv auf den cache zu verschieben. Manuell kannst du das auch machen, musst aber eben aufpassen und wissen was Du da machst!
-
kommt natürlich drauf an. kontrolle wäre besser. keiner weiß, wie viele appdata-Daten Du so hast und wieviel auf dem Cache noch frei ist. Auf der Seite "Start" bzw "main" siehst Du den freien Platz des Caches. und wenn Du die Konsole öffnest und "du -hs /mnt/user0/appdata" (ja, mit der "0", siehe Info) eingibst, wird dir angezeigt, wie viel Platz die appdata-Dateien auf deinem Array belegen - die müssen ja noch auf deinen Cache passen. Theoretisch könnten Deine Appdaten ja größer als der freie Platz auf deiner 128GB SSD sein (eben weil der Mover neue Dateien bislang immer nachts aufs große Array verschoben hat), von daher würde ich das mal checken. zur Info: /mnt/disk1/appdata ist der Ordner auf der jeweiligen Array-disk Nr1 /mnt/cache/appdata ist der Ordner auf dem Cache-Laufwerk (cache ist bei Unraid auch nur der Standardname des ersten pools) /mnt/poolname/appdata ist also der Ordner auf dem jeweiligen Pool "poolname" /mnt/user0/appdata fasst alle arraydisks zusammen /mnt/user/appdata fasst das Array mit allen pools zusammen eine Möglichkeit nur alle Pools zusammenzufassen gibt es nicht! Macht auch wenig Sinn, da man mit dem Mover pro share nur zwischen dem einen Array und einem bestimmten Pool hin und her moven kann und nicht z.B. von pool1 zu pool2. (das wäre noch ein Feature-Wunsch für die Zukunft). Dementsprechend braucht es diese Zusammenfassungsmöglichkeit aktuell nicht. Ich zitiere aus der Lösung: was noch unklar war: mit prüfen meine ich folgendes: du hast doch jetzt erkannt, dass noch dateien unter /mnt/disk*/appdata liegen....prüfe, ob die dort nach dem Mover-Durchlauf auch dann eben nicht mehr liegen. Dann hat er alles zurück verschoben.Wenn dort Dateien überbleiben oder es Fehlermeldungen gibt, sollte man sich das nochmal ansehen. Aber wie gesagt, das ist eher theoretisch, das sollte klappen. Ansonsten wenn du 100%ig sicher sein willst, mach doch von jedem Ordner vor dem Mover-Durchlauf ein Backup, z.B. über die Konsole: cd /mnt/cache cp -ra appdate appdata_sicherung cd /mnt/disk1 cp -ra appdate appdata_sicherung cd /mnt/disk2 cp -ra appdate appdata_sicherung cd /mnt/disk3 cp -ra appdate appdata_sicherung Wenn du dann später deine ssd tauschen willst, kannst Du das auch alles wieder mit dem Mover (für jeden Share einzeln) machen: primary/secondary definieren und über die mover-action steuern, wohin verschoben werden soll. Du kannst die neue SSD auch parallel einbauen (sofern du noch einen Anschluss frei hast) und daraus einen neuen Pool erstellen und nur einzelne Shares darauf verschieben, ist halt alles flexibel. Man kann das Verschieben aber auch manuell über die Gui oder die Konsole machen. Ich glaube für Anfänger ist das mit dem Mover aber einfacher/sicherer...
-
Das ist eher ein theoretisches Problem, was eher dadurch verursacht wird, wenn jemand manuell durch kopieren oder Backups erstellen in die ordnerstruktur eingreift und wenn der nicht aufpasst, was er macht…. Beim regulären verschieben des Movers sollte das hingehen nicht passieren. Da würde ich mir diesbezüglich keine Sorgen machen, ein Backup ist natürlich immer gut😉 Den mover kannst du manuell starten auf der Main Seite oder einfach warten bis er (nachts) automatisch läuft. Ersteres bringt dich meistens früher zum Ziel Was mir noch einfällt: achte vor dem verschieben darauf, dass du auch genug Platz auf dem Cache hast damit da auch das komplette appdata aus dem Array draufpasst…
-
War missverständlich geschrieben, hast Recht, sorry. Aber eigentlich ist es auch egal, man kann auch alle Container einzeln beenden und den Dienst anlassen. Es geht hier ja nur darum, dass kein Container mehr Daten auf appdata schreibt. Den Dienst zu beenden (wobei dann automatisch alle Container beendet werden) ist einfacher, schneller und sicherer, da die Gefahr nicht besteht, das beenden eines Container zu vergessen.
-
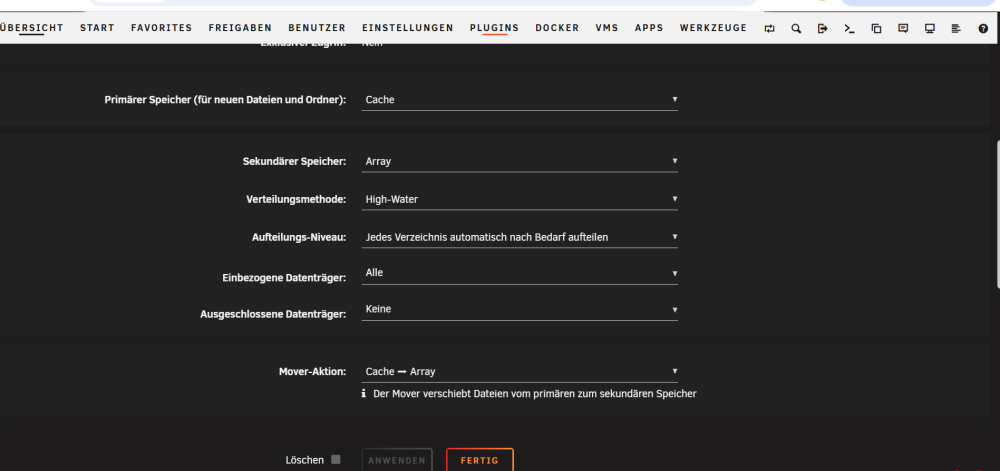
Wenn du zu ängstlich bist, mach vorher ein Backup der Ordner von jedem Laufwerk. Ja, mover-Action umdrehen in der Share konfig, siehe dein Screenshot: Dann führt das beim nächsten mover durchlauf dazu, dass er alle appdata Dateien vom Array, also von allen disks des arrays verschiebt auf /mnt/cache/appdata. Also eben genau andersrum als das verschieben aufs Array. Danach solltest du dann keine Dateien mehr unter /mnt/disk*/appdata mehr haben…
-
Sag ich ja: „Docker ausschalten“ - damit meine ich natürlich den Dienst. Das Mergen macht ja der mover. Laut den Einstellungen oben werden neue Dateien auf dem Cache geschrieben und nachts dann vom mover aufs Array geschoben. Genau das macht man jetzt rückgängig. Problematisch wird es wenn es eine bestimmte Datei z.B. auf beiden (Cache/array) gibt. Das sollte nicht vorkommen denn dann würde das mergen auch Probleme machen….
-
Genau: Docker ausschalten Mover Action drehen (also Array—>cache) Mover starten Dann sollte alles auf dem Cache liegen (Prüfen!) Dann secondary Storage rausnehmen Docker wieder starten keine neuinstallation notwendig!
-
wie kommst du zu der Annahme? wenn du in der docker config 8081 einstellst, sollte er eigentlich auch diesen Port nutzen... deswegen denke ich auch, dass das eigentliche Problem woanders liegt. Hast Du mal in die Logs das Immich Containers geschaut, was da steht?
-
wie ist denn deine Freigabe "appdata" konfiguriert? und viel wichtiger: war das mal anders oder hast du vielleicht früher ganz ohne cache gearbeitet und nie alles korrekt auf den Cache umgezogen vom Array? n bisschen Historie wäre gut
-
natürlich gar nicht 😂 ja ok, ich hatte das so verstanden, als würden die Ryzens degenerieren, das hörte sich so an als käme das öfter vor....und davon hab ich halt noch nie gehört und wollte nur zum Ausdruck bringen, dass ich durchaus auch einige ältere Systeme im Einsatz habe, die keinerlei Anzeichen diesbzgl. machen. Beruflich setzen wir außer in Mitarbeiter Laptops keine Comsumer CPUs ein, daher hab ich da auch keine Erfahrungswerte, hab aber auch noch nie mitbekommen, dass wir im RZ Umfeld defekte CPUs tauschen. das denke ich auch, bin wie gesagt gespannt auf das Ergebnis
-
Ich finde den Thread sehr interessant, da ich davon bei AMD Ryzen bislang noch nie gehört habe. In meiner Familie hab ich seit 2018 drei 2000er, zwei 3000er und zwei 5000er Ryzen zusammengebaut, die seither im Einsatz sind und ohne Probleme laufen (zwei davon hab ich zudem gebraucht erworben), aber zugegeben läuft davon keiner 24/7, dafür sind sie mir zu ineffizient im idle 😉 Mein einziger Rechner, der jemals ähnliche Abstürz-Probleme zeigte, war mein Intel-Backupserver, wo offenbar Sockelkontakte auf dem gebrauchten Board verbogen waren, was bei Sockel1700 angeblich öfter mal auftritt 🤔. Nach Board-Tausch war das Problem weg. Solche Probleme sind bei AMD-Sockeln per Design eher ausgeschlossen, von daher bin ich sehr gespannt, ob's wirklich an der CPU liegt, soo alt ist sie ja nun auch nicht....