_alo_
Members
-
Joined
-
Last visited
Everything posted by _alo_
-
Warum, was kommt für ein Fehler und an welcher Stelle? Steht dazu irgendwas im System-Log? d.h. sie liegen jetzt auf dem "cache"-Pool auf der 1TB SSD, was du eigentlich nicht wolltest, richtig?!
-
Sicher? Weil du sie mangels Formatierung eben nicht (!) wiederhergestellt hast. Das zeigen die Screenshots aber nicht Ich schrieb von zwei getrennten Pools. „Cache“ist nur der defaultname des ersten Pools (weil der eben i.d.R. auch als schreib“Cache“ vorgesehen ist), mehr nicht. Du kannst aber auch mehrere Pools anlegen nicht nur einen „Cache“-Pool. 2 ssds in einem Pool ist dann sinnvoll, wenn diese identisch groß sind und du einen spiegel also Redundanz erstellen willst (raid1). Wenn du mehrere Pools hast, kannst du pro Share natürlich definieren, welcher wo liegen soll. Auch dem Docker Dienst sagt man in der konfig auf welchem Ordner er liegen soll. Das ist jetzt ein mirror aus zwei unterschiedlich großen ssds. Das kann nicht funktionieren (bzw. doch: bis max 256gb schon, was natürlich Verschwendung der großen 1TB wäre), das solltest du also besser wieder auflösen.
-
...und da siehst Du es ja bei beiden SSDs: "Unmountable: unsupported or no filesystem" d.h. direkt unter diesen Laufwerksangaben im Main-Tab bei den Array-Operationen sollte der Hinweis auf nötige Formatierung der Laufwerke kommen. Das wirst du einfach noch nicht gemacht haben, richtig? also ist es noch nicht zu Ende eingerichtet 😉 Ohne Dateisystem können sie nicht ins System eingebunden werden und ohne das kannst du auch nicht auf sie schreiben. Ah, jetzt verstehe ich das mit der NVMe auch: Du hast sie einfach dem Array hinzugefügt. Und Du willst die shares appdata und system dann so einrichten, dass sie ausschließlich diese NVMe nutzen sollen?! Ja, dann werden die Daten darauf auch per Parity geschützt, aber das heißt auch gleichzeitig: Höherer Stromverbrauch: die Parity-HDD läuft quasi dauerhaft, weil eigentlich immer was bei den docker Containern geschrieben wird geringere Geschwindig: der Geschwindigkeitsvorteil der NVMe ist nicht mehr gegeben, da immer paralell auf NVMe und HDD (parity) geschrieben wird. Das ganze wird also so langsam wie auf das Schreiben aufs Array sonst auch ist Wenn es dir nur um docker geht: Ich würde die 256GB NVMe als Pool konfigurieren, darauf dann die ganzen Standard-Systemshares als pool-only ablegen (so wie unraid das standardmäßig konfiguriert, wenn du mit pool und array startest). Die Daten würde ich dann per appdata-Backup-Plugin täglich aufs Array sichern, System brauchst Du nicht sichern, das lässt sich besser neu erstellen im Fehlerfall. Die Intenso 1TB als weiteren Pool dann also nur als Schreibcache bzw. für Daten, die schnell verfügbar aber ungesichert dort liegenbleiben sollen/dürfen ...
-
sorry, ich war noch nicht dazu gekommen, mir die Diagnostics anzuschauen.... kein Problem, also die Intenso SATA SSD. die wird in der Config mit diskSize="0" angegeben, das ist merkwürdig bzw. erklärt, wieso Du darauf nichts schreiben kannst. Hier sollte eigentlich die Größe der Partition stehen, also z.B. diskSize="976761560" wie bei meinem 1TB Cache-Pool. Mit welchem Dateisystem hast Du sie formatiert? in der Konfig steht diskFsType="auto".... xfs würde ich hier empfehlen... also denke ich, Du hast die neue SSD noch nicht richtig eingebunden, vielleicht wäre ein Screenshot von Main hier gut. das verstehe ich leider auch nicht wo ist die NVMe eingebunden? Ich kann hier keinen zweiten Pool finden... und was hat die Parität eines Pools mit einer NVMe (als Pool?) zu tun? Oder möchtest du etwa ein Array als ZFS-Konstrukt bauen?
-
Achso nee, k.A., das brauche ich nicht, die usv sichert nur den Server ab, alles andere angeschlossene muss nicht runtergefahren werden.
-
Ich habe ja mittlerweile auch diese beiden Hersteller an meinen Servern hängen und wüsste nicht wofür ich NuT brauche, das integrierte funktioniert. 🤷🏻♂️
-
Ja das wusste ich ja auch vorher aber da es sich nur um ein mini pihole handelte, dachte ich, ich probier den theoretisch einfacheren Weg mal … Nur eine 50/50 Erfolgschance bin ich von unixoiden Systemen nicht gewohnt 🤣 Es wäre halt interessant zu wissen woran es liegt… Rechte glaube ich weniger, da bei mv ja alle mitgenommen werden sollten. 🤔 Da sich nur die disk geändert hat, denke ich eher an eine Verknüpfung mit dieser - ist aber nur eine Vermutung (bin wie ihr merkt kein docker Experte)… Aber dann würden 100% nicht funktionieren… bei fehlenden Rechten allerdings auch - oder betrifft es Deiner Erfahrung nach dann nur einen Teil der Container? Tritt das Thema auch auf ohne disk-Wechsel, nur durchs hin und herschieben? Das könnte ich ja nochmal testen… Oder bewirken zwischenzeitliche Reboots ggf. Etwas? Ich Probier nochmal n bisschen 😉falls keiner hier den passenden Hinweis liefern kann.
-
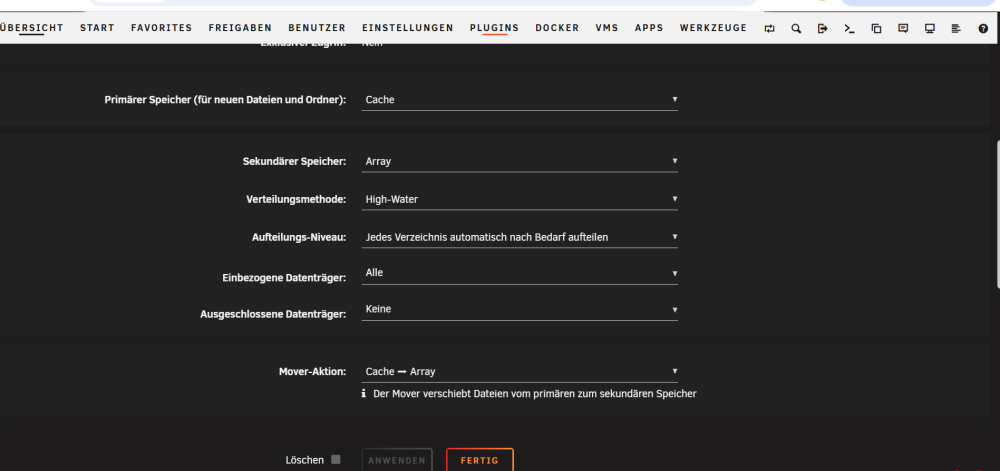
Ein kleiner Erfahrungsbericht, vielleicht hilft er ja anderen bei ähnlichen Problemen/Fragestellungen. Ich hab gerade die Cache-SSD in meinem Backup-System (7.3.2) getauscht, nach folgendem Prozedere: docker Service stoppen (VM hab ich hier keine) alle meine Cache-only Shares (apdata/domains/system/isos/...) auf secondary-storage=array gestellt (und darauf geachtet, dass alle anderen Schreibcache-shares aktuell nicht genutzt werden) mover-action steht dann automatisch auf cache-->array mover manuell gestartet Kontrolle: /mnt/cache ist leer und alle zuvor angepassten Shares liegen auf /mnt/disk... Server runterfahren SSD umbauen Booten Problemchen 1: unraid-Oberfläche kommt nicht wieder 🤔 Grund: 🤦♂️auf der SSD war noch ein altes Ubuntu installiert, sie hat sich dadurch im BIOS in die boot-Reihenfolge vor den USB-Stick geschoben 🙄 Lösung: Bildschirm/Tastatur/Maus dran; STRG/ALT+DEL...DEL...BIOS: Boot-Reihenfolge ändern...SAVE+BOOT...weiter geht's 😉 unraid Oberfläche wieder da Array startet logischerweise nicht, weil cache-disk nicht gefunden werden kann dem Pool "cache" die richtige/neue SSD zuweisen Formatierung von cache anpassen von btrfs auf xfs (es ist ein single-disc cache) Array starten nicht mountbare Laufwerke formatieren (betrifft die neue SSD - ist ja noch ubuntu drauf) Cache wieder vorhanden in allen zuvor angepassten shares die mover-action umdrehen auf array-->cache Mover wieder manuell starten Kontrolle: alle betroffenen shares liegen jetzt wieder ausschließlich auf /mnt/cache (^=cache-only) optional: secondary-storage wieder auf none setzen (hat ab jetzt eh keine Auswirkungen mehr) docker service wieder aktivieren System sollte wieder laufen soweit, so klar.....eigentlich... Problem 2: Was mich aber wunderte: wieso fehlen anschließend die docker-container? Die Liste war leer. Ich habe /mnt/cache/system (docker im directory modus; storage driver= native) lediglich hin und hergeschoben und nicht neu erstellen lassen, eigentlich sollten doch alle Infos über bestehende Container vorhanden sein und beim Servicestart sollten diese dann doch auch wieder mindestens auftauchen und aufgrund von autostart=on auch direkt wieder hochkommen, oder? Ich sehe den Unterschied gerade nicht zu einem normalen reboot. Der mover sollte die Daten ja jedes Mal 1:1 verschieben🤔. Ist in den Untiefen von Docker irgendwo das Laufwerk selbst (UUID) mit den Containern verknüpft, o..ä.? Grund: ? Lösung: Docker --> add_container: das auf dem Stick gespeicherte User-Template für den Container nehmen und ihn wiederherstellen, dabei hat er das container-image neu runtergeladen (nicht schlimm aber auch seltsam - sollte er das nicht schon haben? Der Container war auf dem aktuellsten Stand), die Einstellungen sind also wiederhergestellt und Appdata ist ja auch vorhanden für die persistenten Daten. Soweit also inkl. Umbau/Mover nach 5min alles wieder funktionsfähig (war nur ein Container 😉), aber es wundert mich schon, wieso die Dockerliste leer war - hat jemand eine Erklärung? was hab ich übersehen?
-
dass jemand eine Festplatte für den Cache nimmt, hab ich zwar noch nie gehört, aber ok, jeder wie er mag. und warum nicht nur eine (etwas größere) NVMe für beides? wie hast du das denn konfiguriert? Screenshot vom "Main" wäre zum Start ganz gut, oder gleich die Diagnostics hier hochladen. was sagt das Log dazu? ja, kann sein und nein, ohne mehr Infos natürlich nicht ;)
-
Daran dachte ich auch erst aber die alten lizenzen (er hat plus ich pro) konnten ja noch dauerhaft Updates bekommen und waren nur bzgl Laufwerke beschränkt oder?
-
eigentlich nicht. ich bin damals mit 6.12.5(?) angefangen, deine Ansicht kenne ich so nicht, aber die Quelle der Updates hat sich m.W. nie geändert - da können andere vielleicht mehr zu sagen, die schon länger dabei sind. Ansonsten würde ich an deiner Stelle ruhig diesen Zwischenschritt machen (in der Hoffnung, dass danach das Update auf die aktuelle Version angeboten wird), kann ja nicht schaden...
-
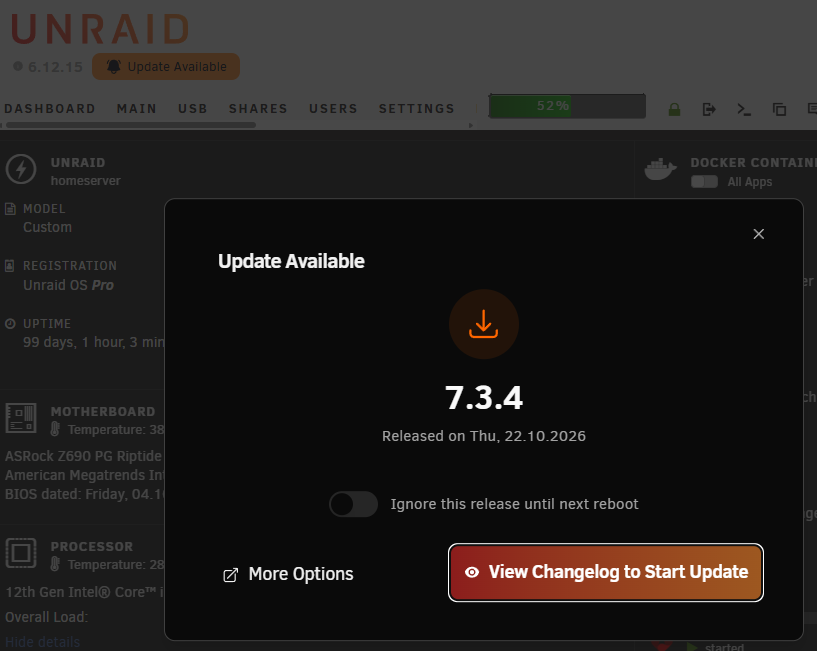
seltsam, ich bin auch noch bei 6.12(.15), aber bei mir wird direkt der große Sprung angezeigt: Ich stehe mit dem Server also auch noch vor dem Update. Wie ich vorgehen werde: alle docker + Plugins auf Aktualität prüfen Backups erstellen (auf separates System), auch vom Stick Screenshot vom Main erstellen mit allen Laufwerkszuordnungen Dienste (docker/VM) stoppen automatisierte Skripte, die irgendwas am System Verändern, stoppen Array stoppen und autostart rausnehmen unraid-Update durchführen, auf Fehler/Hinweise achten nach erfolgreichem reboot schauen ob alles wieder da ist bzw. erkannt wurde und ASPM noch passt Hinweisen aus Updateprozess nachgehen Array starten und NAS Funktionalitäten prüfen docker/VM starten und Dienste prüfen sonst: rollback ...wenn ich dafür mal Zeit/Lust habe Nextcloud scheint ja generell etwas aufwendiger zu sein (AIO Setup?), hab ich nicht im Einsatz, aber hier ist vielleicht genauer zu schauen ....
-
ich habe hier ein ähnliches Setup (TVs & Heimkino). das neue AppleTV lohnt sich m.M.n. hierfür nicht (kann immer noch kein passthrough), ich habe 2 der Vorgänger im Kino und Wohnzimmer im Einsatz (und suche eigentlich auch noch ein drittes fürs Gästezimmer). Jellyfin läuft sonst bei meinem Sohn auch relativ gut auf einem der neueren atmos-fähigen 4k FireTV-Stick (unklar, welcher das genau ist). Ansonsten geht natürlich jeder PC-Client mit kodi/jellyfin von einem raspberryPi bis zu einem ausgewachsenen HTPC (mit madvr und gaming-GPU für dynamisches Tonmapping, wenn Du richtige Videoqualität suchst😉) ziemlich gut. Dann gibt es ja auch noch diverse Android-Medienplayer, die Netzwerkshares mounten können und quasi genau dafür gebaut wurden, schau z.B. mal bei zidoo vorbei...
-
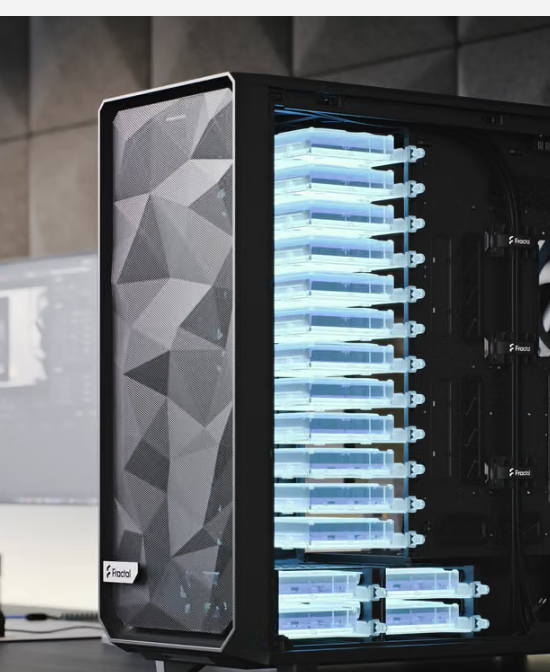
Kann ich nachvollziehen, ich war anfangs auch positiv überrascht, als die N-Serie rauskam (nicht-19"-Gehäuse für viele HDDs gibt es kaum noch). Leider hatten bislang alle Varianten (für mich) Nachteile wie "falscher" Netzteil-Formfaktor, zu knapper Bauraum bzw. mangelnder Airflow, Holzoptik und Preis. Das N6 scheint da in einigen Themen besser zu sein, als die Vorgänger 👍 Das Node804 ist schon alt, hat auch seine Schwächen (da dürfte gern mal eine überarbeitete Version erscheinen), aber für meine Zwecke voll ok und vor allem oft vergleichsweise günstig. besser entkoppelt als das Node würde ich nicht sagen: du schraubst die HDDs über die gleichen Gummies an, wie beim Node804, aber in einzelne Käfige, die wiederum auf der einen Seite nur in eine Blechnase gefädelt und auf der anderen Seite verschraubt werden - das könnte(!) schon eher als beim Node rappeln, tut es aber bei mir nicht. Wobei ich dazusagen muss, dass die 6 HDDs auch größtenteils im spindown sind, da sie selten was zu tun haben. Das meiste läuft über docker/vm im "cache"-Pool oder über einen weiteren SSD-Pool, den ich fürs tägliche Arbeiten und als NAS-Schreibcache nutze. aber besser umlüftet sind sie definitiv: in der sehr offenen Front hab ich drei langsame/leise 14cm Lüfter verbaut, die seitlich direkt die Platten umpusten, diese haben ausreichend Abstand zueinander und der Airflow wird nur minimal durch die Käfige behindert, siehe Bild Mehr Volumen bedeutet nunmal einfach bessere Belüftungsmöglichkeit! Wenn man viele Platen auf engem Raum verbauen will, kommt man an den Jonsbos kaum vorbei, aber dann kann(!) es warm oder durch die Lüfter laut werden. Das Node804 (und zuvor das 304 ITX) war für mich immer ein guter Kompromiss aus Lüftung/Platz und ausreichender Anzahl HDDs. vom Platz her könnte man im 804 noch einige HDDs mehr unterbringen, aber dafür gibt es ja 3D-Drucker 😉 Das Meshify2 ist aber auch ein riesiges full-ATX-Gehäuse für eine Menge Platten:Bei mir war schnell klar, dass die Features, die ich haben wollte, nur von full-ATX Boards bereitgestellt werden, daher war dann auch schnell Schluss mit Mini-Gehäusen ... Generell sehe ich(!) aber das Thema HDD-Entkopplung bzw. Gehäuse-Rappeln durch HDDs bei unraid-Servern nicht so wirklich. Aktuell stehen beide Server bei mir im Büro/Gästezimmer und eigentlich läuft maximal nur auf einem der Mover nachts kurz (wenn überhaupt), d.h. die HDDs schlafen i.d.R. über 23,5h am Tag. Das ist aber natürlich sehr individuell und andere stört da jedes Geräusch. Bei mir sind die Platten auf jeden Fall lauter als etwaige Gehäusegeräusche, wenn sie kurz laufen... Damm kommen noch die Lüftergeräusche dazu und da sind kleine Gehäuse leider im Nachteil: wenig Volumen --> stärkere bzw. schnellere Erwärmung --> mehr Lüftungs-Durchsatz erforderlich oft nur kleine Lüfter möglich --> diese müssen schneller drehen oder es müssen mehr verbaut werden für den nötigen Durchsatz (mehr) schnell drehende Lüfter sind laut und regen ggf. zusätzlich das Gehäuse mehr zum Schwingen/Rappeln an Also immer ein Kompromiss! Auf zwei Server aufteilen macht m.M.n. (gerade vom Stromverbrauch) überhaupt keinen Sinn bei unraid, denn dafür ist es doch optimiert mit der Nutzung von Pool(s) und Array.
-
Das ist mein Backupserver ohne Parity 😉 aber nein, ein durch die HDDs verursachtes Rappeln hab ich da noch nicht wahrgenommen. Die HDDs sind durch die Gummies entkoppelt und die Käfige sitzen recht fest in den Schienen. Airflow ist vielleicht besser als in den engen jonsbos, aber auch nicht optimal, da die Front größtenteils geschlossen ist und die Käfige den Airflow etwas behindern. Ich habe mittlerweile vorne und hinten nen 14cm Lüfter spendiert, damit die HDD-Temperaturwarnungen beim längeren Backupjob ausbleiben. Mein Meshify2 ist dahingehend einiges besser, aber natürlich auch viel größer... so spät? P.S.: wofür Wechsel-Rahmen?
-
Also mein node804 hat beides nicht, nur 2 Montagerahmen für je 4 HDDs… Edit: da rappelt nichts
-
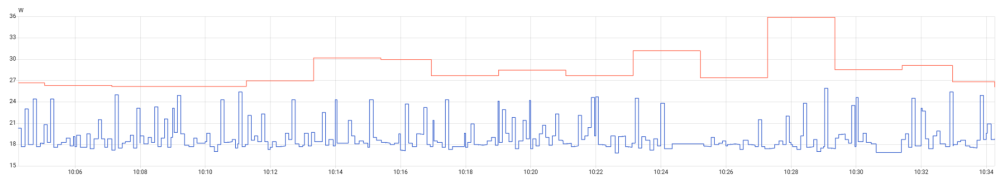
mein aktueller Verbrauch meiner Systeme aus der Signatur (rot=main, blau=backup): (das nackte System aus Board/CPU/Ram/USB-Stick/picoPSU brauchte jeweils minimal um die 10W) die 10G Netzwerkkarte meines großen Severs scheint übrigens leider gestorben zu sein :( da muss ich nochmal ran... Das ASUS N100I-D4 hab ich nicht wirklich viel stromsparender als das B760M bekommen und ist deswegen zugunsten der weiteren Möglichkeiten des größeren Systems rausgeflogen bzw. in mein 10" proxmox-Test-Cluster umgezogen. Bei mir hatte das Entfernen des an die HA-VM durchgereichten conbeeII USB-Sticks einiges gebracht. Ich bin auf einen (zentraler positionierten) SLZB06 mit PoE umgestiegen, weiß aber ehrlich gesagt gar nicht, was der verbraucht. Jetzt hab ich allerdings an beiden Servern eine USV per USB hängen 🤔
-
auch noch ein paar Punkte von mir: das war mir neu/unklar und hab das mal nachgelesen: für den reinen Betrieb braucht xfs quasi nichts, aber wenn xfs_repair notwendig wird, könnte es RAM-hungrig werden: demnach kämst du bei 14TB HDD so schnell in Richtung von eher 32GB als 16GB.... stimmt, aber diese Info ist auch fast 20 Jahre alt.... Wenn man hierzu genauer sucht: Diese Logik basiert primär auf der Anzahl an Inodes (Dateien auf der Platte) kommt noch aus einer Zeit, als Festplatten recht klein waren und bezog sich auf den Anwendungsfall im Datacenter von extrem vielen kleinen Dateien (Mailserver etc), also Millionen Dateien pro TB. Selbst dann war der RAM weniger das Problem, da dann auf den SWAP ausgewichen wurde. Heutzutage kommen -wie bei Dir mit Jellyfin- typischerweise vergleichsweise wenige große Dateien vor und dort reduziert sich der RAM-Bedarf schon wieder extrem ("bei 14TB Kapazität benötigt xfs_repair je nach Anzahl Dateien typischerweise zwischen 4 und 8GB RAM, selten mehr als 6GB"). Also ist der RAM bei xfs denke ich unkritisch und daher iirc auch hier im Forum bislang kein Thema gewesen... Bei wilden zfs-Konstrukten mag das anders sein. Naja, nur weil das Netzwerk 2,5GE kann, heißt das ja noch lange nicht, dass die auch durchgängig übertragen werden, da gehört ja noch einiges mehr zu. Das ist oft ein Denkfehler, das Netzwerk (oder den Maximalspeed einer HDD/NVMe) alleine zu betrachten. Da ist ja noch mehr beteiligt (und da steht für mich das Filesystem recht weit hinten in der Kette der beeinflussenden Faktoren): Quell-System (wie schnell kriegt das System die Daten überhaupt losgeschickt (HDD/SSD, CPU, Dateigröße/-anzahl, Betriebssystem/Anwendung,...)?) Anbindung Quell-System ans Netzwerk (LAN, WLAN) Netzwerk (beteiligte Geräte, Konfiguration, z.B. flow-control an/aus, ausreichende routing/switching Kapazität?) Anbindung Ziel-System ans Netzwerk (LAN, WLAN) Performance des Ziel-Systems (wie schnell kriegt das System die Daten von der Netzwerkkarte zum Speicher? CPU/RAM-Auslastung, PCIe Anbindung der Geräte, SMB/NFS, RAID-Controller...) Speicher Geschwindigkeit (z.B. SATA ca. 250MB/s, NVMe PCI3.0X4 ca. 4GB/s,... mit den zusätzlich einschränkenden Faktoren, die @DataCollector beschrieben hat) Dateisystem (sicherlich im Bereich des Messbaren) das kann also überall haken. Erst wenn alle Komponenten mitspielen bzw. richtig ausgelegt sind, erreichst Du auch die gewünschten Übertragungsraten. Vielleicht ist das ugreen NAS auch einfach so ausgelegt, dass es die >1GE nur über einen SSD-Cache ausreizen kann, wenn überhaupt...
-
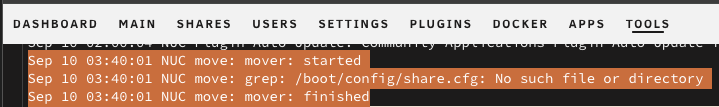
🤣ok Jetzt hab ich hierzu allerdings auch mal eine Frage an die Profis und möchte keinen extra Thread aufmachen - ich hoffe auf eine kurze Antwort wieso bekomme ich beim nächtlichen Mover-cronjob immer eine diese grep Fehlermeldung: Sep 30 03:40:01 NUC move: mover: started Sep 30 03:40:01 NUC move: grep: /boot/config/share.cfg: No such file or directory Sep 30 03:40:01 NUC move: mover: finishedbeim manuellen Aufruf aber nicht: Sep 30 18:48:19 NUC move: mover: started Sep 30 18:48:19 NUC move: mover: finishedP.S.: die /boot/config/share.cfg gibt es, mit diesem Inhalt: # Generated settings: shareDisk="auto" shareUser="e" shareUserInclude="" shareUserExclude="" shareUserEmptying="" shareUserExclusive="no" shareSMBEnabled="yes" shareNFSEnabled="no" shareNFSFsid="100" shareInitialOwner="Administrator" shareInitialGroup="Domain Users" shareCacheEnabled="yes" shareCacheFloor="2000000" shareMoverSchedule="40 3 * * *" shareMoverLogging="yes" shareNameVeto="/lost+found/LOST+FOUND/" fuse_remember="330" fuse_directio="auto" fuse_useino="yes" shareNOFILE="" shareAvahiEnabled="yes" shareAvahiSMBName="%h" shareAvahiSMBModel="Xserve"
-
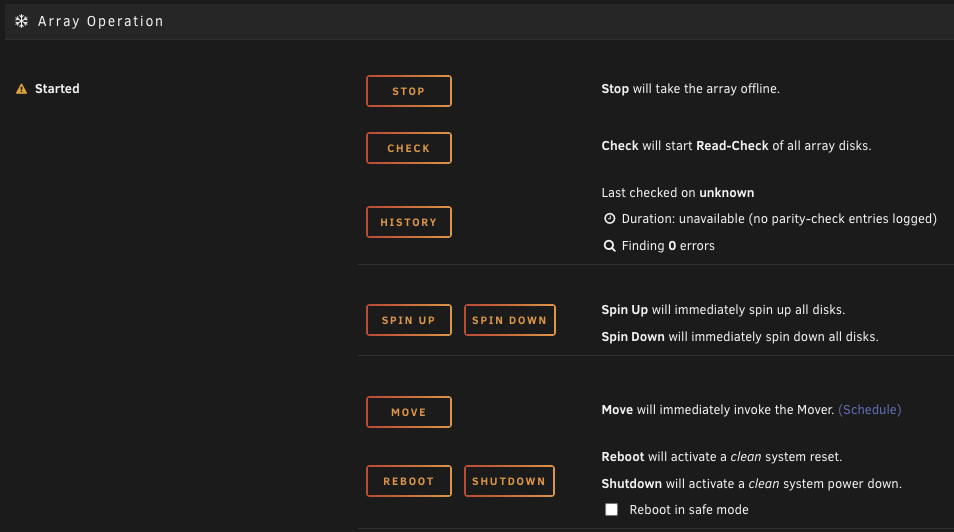
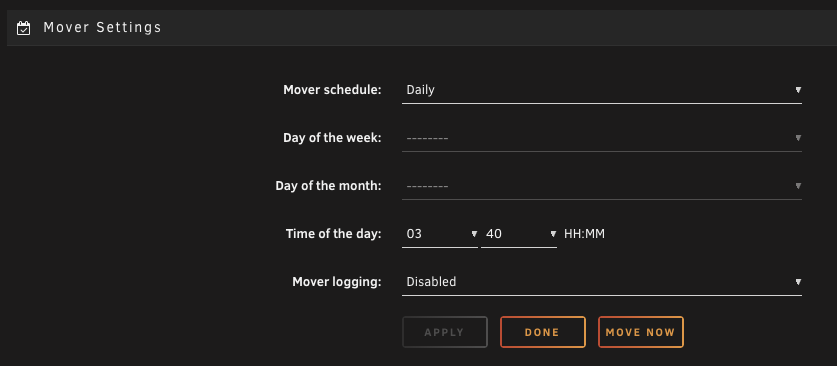
wann? wie du möchtest. Auf dem Main-Tab siehst Du unten bei den Array Operationen den Button "Move" - der ist zum manuellen Starten des Movers, so wie es dahinter auch beschrieben ist: hinter der Beschreibung ist dann der Link zum Scheduler, hier stellt man ein, wann der Mover laufen soll (täglich ist so default, es kann sein, dass ich die Uhrzeit angepasst habe): Auch hier kannst Du "Move now" anklicken, sollte das gleiche wie auf der Main Seite sein. Du siehst, dass er nach seiner Scheduler-Eintrag nachts startet und direkt fertig ist bei mir, da es keine zu movenden Daten gab: im Syslog unter Tools --> System Log Wenn Du in den Mover Settings noch das Logging aktivierst, wirst Du hier wahrscheinlich etwas mehr (jede Datei?) sehen. Ich hab gerade nichts zu moven, aber so siehts dann im Syslog aus, wenn ich "Move Now" klicke: mit der Uhrzeit von jetzt, sonst gleich ;) Ob er alles bewegt hat? Da geh mal von aus, wenn sie aktuell nicht im Zugriff sind (deswegen dürfen die Docker nicht laufen!), werden sie verschoben. Und sonst kannst Du -wie schon gesagt- ja auch nachsehen.
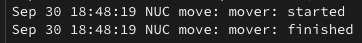
-
Genau, der "cd" Befehl bedeutet "change directory", d.h. du Wechselst in das angegebene Verzeichnis (alle Laufwerke sind ja in dem einem Verzeichnisbaum eingehängt/gemountet). Der nächste "copy"-Befehl "cp -ra [Quelle] [Ziel]" wird dann in diesem Verzeichnis ausgeführt. Er kopiert also das appdata Verzeichnis in ein neues Verzeichnis "appdata_sicherung", das Verzeichnis wird dabei automatisch erstellt. Die Option "-r" sorgt dabei dafür, dass rekursiv auch alle Unterverzeichnisse mitkommen und das "-a" dafür, dass alle Attribute übernommen werden (Eigentümer, Rechte, Zeitstempel,....). ja könntest du auch mit folgenden Anmerkungen: solche Operationen übers Webinterface machen, dauert nach meiner Erfahrung ewig, da wäre die Konsole schon tausendmal fertig. Aber es ist grundsätzlich möglich. da Ziel/Target muss dabei richtig gewählt werden!! Wenn du in /mnt/disk1/appdata gehst, dort alles markierst und als Ziel fürs Verschieben /mnt/cache (die SSD) auswählst, hast Du anschließend die Docker-Daten unter z.B. /mnt/cache/jellyfin und nicht /mnt/cache/appdata/jellyfin. Wenn man sowas manuell macht, muss man eben genau aufpassen, was man tut. Der Mover macht nichts anderes, als die Share-Ordner (hier: appdata) auf allen Laufwerken des arrays zu suchen und datei für datei rekursiv auf den cache zu verschieben. Manuell kannst du das auch machen, musst aber eben aufpassen und wissen was Du da machst!
-
kommt natürlich drauf an. kontrolle wäre besser. keiner weiß, wie viele appdata-Daten Du so hast und wieviel auf dem Cache noch frei ist. Auf der Seite "Start" bzw "main" siehst Du den freien Platz des Caches. und wenn Du die Konsole öffnest und "du -hs /mnt/user0/appdata" (ja, mit der "0", siehe Info) eingibst, wird dir angezeigt, wie viel Platz die appdata-Dateien auf deinem Array belegen - die müssen ja noch auf deinen Cache passen. Theoretisch könnten Deine Appdaten ja größer als der freie Platz auf deiner 128GB SSD sein (eben weil der Mover neue Dateien bislang immer nachts aufs große Array verschoben hat), von daher würde ich das mal checken. zur Info: /mnt/disk1/appdata ist der Ordner auf der jeweiligen Array-disk Nr1 /mnt/cache/appdata ist der Ordner auf dem Cache-Laufwerk (cache ist bei Unraid auch nur der Standardname des ersten pools) /mnt/poolname/appdata ist also der Ordner auf dem jeweiligen Pool "poolname" /mnt/user0/appdata fasst alle arraydisks zusammen /mnt/user/appdata fasst das Array mit allen pools zusammen eine Möglichkeit nur alle Pools zusammenzufassen gibt es nicht! Macht auch wenig Sinn, da man mit dem Mover pro share nur zwischen dem einen Array und einem bestimmten Pool hin und her moven kann und nicht z.B. von pool1 zu pool2. (das wäre noch ein Feature-Wunsch für die Zukunft). Dementsprechend braucht es diese Zusammenfassungsmöglichkeit aktuell nicht. Ich zitiere aus der Lösung: was noch unklar war: mit prüfen meine ich folgendes: du hast doch jetzt erkannt, dass noch dateien unter /mnt/disk*/appdata liegen....prüfe, ob die dort nach dem Mover-Durchlauf auch dann eben nicht mehr liegen. Dann hat er alles zurück verschoben.Wenn dort Dateien überbleiben oder es Fehlermeldungen gibt, sollte man sich das nochmal ansehen. Aber wie gesagt, das ist eher theoretisch, das sollte klappen. Ansonsten wenn du 100%ig sicher sein willst, mach doch von jedem Ordner vor dem Mover-Durchlauf ein Backup, z.B. über die Konsole: cd /mnt/cache cp -ra appdate appdata_sicherung cd /mnt/disk1 cp -ra appdate appdata_sicherung cd /mnt/disk2 cp -ra appdate appdata_sicherung cd /mnt/disk3 cp -ra appdate appdata_sicherung Wenn du dann später deine ssd tauschen willst, kannst Du das auch alles wieder mit dem Mover (für jeden Share einzeln) machen: primary/secondary definieren und über die mover-action steuern, wohin verschoben werden soll. Du kannst die neue SSD auch parallel einbauen (sofern du noch einen Anschluss frei hast) und daraus einen neuen Pool erstellen und nur einzelne Shares darauf verschieben, ist halt alles flexibel. Man kann das Verschieben aber auch manuell über die Gui oder die Konsole machen. Ich glaube für Anfänger ist das mit dem Mover aber einfacher/sicherer...
-
Das ist eher ein theoretisches Problem, was eher dadurch verursacht wird, wenn jemand manuell durch kopieren oder Backups erstellen in die ordnerstruktur eingreift und wenn der nicht aufpasst, was er macht…. Beim regulären verschieben des Movers sollte das hingehen nicht passieren. Da würde ich mir diesbezüglich keine Sorgen machen, ein Backup ist natürlich immer gut😉 Den mover kannst du manuell starten auf der Main Seite oder einfach warten bis er (nachts) automatisch läuft. Ersteres bringt dich meistens früher zum Ziel Was mir noch einfällt: achte vor dem verschieben darauf, dass du auch genug Platz auf dem Cache hast damit da auch das komplette appdata aus dem Array draufpasst…
-
War missverständlich geschrieben, hast Recht, sorry. Aber eigentlich ist es auch egal, man kann auch alle Container einzeln beenden und den Dienst anlassen. Es geht hier ja nur darum, dass kein Container mehr Daten auf appdata schreibt. Den Dienst zu beenden (wobei dann automatisch alle Container beendet werden) ist einfacher, schneller und sicherer, da die Gefahr nicht besteht, das beenden eines Container zu vergessen.
-
Wenn du zu ängstlich bist, mach vorher ein Backup der Ordner von jedem Laufwerk. Ja, mover-Action umdrehen in der Share konfig, siehe dein Screenshot: Dann führt das beim nächsten mover durchlauf dazu, dass er alle appdata Dateien vom Array, also von allen disks des arrays verschiebt auf /mnt/cache/appdata. Also eben genau andersrum als das verschieben aufs Array. Danach solltest du dann keine Dateien mehr unter /mnt/disk*/appdata mehr haben…